ここまで勉強したように、ニューラルネットワークの学習は損失関数の最小化に帰着されます。これは高次元パラメータ空間において、複雑な目的関数の良い最適解を見出そうとする、非常に難しい問題です。
さらに、深いネットワークでは、パラメータの数が膨大になり、事態はより深刻になってきます。
これを解決に導くため、様々なテクニックが組み合わされて利用されています。
1確率的勾配降下法
勾配降下法で損失関数を最適化する方法としては、学習データの全てのサンプルに対する損失関数を求め、それを最小化することが考えられます。つまり、各サンプル1個に関する損失の和の勾配を用いてを更新する方法を、バッチ学習(batch learning)と呼ぶことにします。
これに対して、一定数のサンプルの集合単位で重みを更新するのが、計算効率の観点からより現実的な選択です。このサンプルの集合のことをミニバッチ(minibatch)と呼びます。
なお、このミニバッチを用いた勾配降下法は確率的勾配降下法(stochastic gradient descent)と呼ばれます。
ここで、ミニバッチ1つをと書きます。添字は回目の更新ごとにそのサンプル集合が変わることを表します。ミニバッチのリストを考え、1つずつ順番に用いて重みを更新します。つまり回目にはが含む全サンプルに対する損失の平均
を計算し、その勾配の方向にパラメータを一度だけ更新します。なお、はこのミニバッチが含むサンプル数です。
ミニバッチをと順番に取り出して使い、一巡したら再度、最初からの順に取り出して使います。ここで、一巡することをエポック(epoch)と呼びます。
ニューラルネットワークの学習では一般に、数エポックから数十、あるいはそれ以上のエポック数分、上の過程を繰り返します。
2過学習問題の制御
過学習(overfitting)とは、機械学習モデルが学習データに対して過度に適合してしまい、新しいデータに対して良いパフォーマンスを発揮できなくなる状態をいいます。機械学習モデルの目的は、学習データには含まれないデータであっても、正しく識別できる汎化性能が望まれます。
そのため、過学習を抑制するテクニックが重要になってくるのです。
2.1重みの減衰
過学習抑制のためによく用いられる手法として、重みの減衰という方法があります。
過学習は、重みパラメータが大きな値を取ることによって発生することが多いため、この手法は、学習の過程において、大きな重みをもつことに対してペナルティを課すことで、過学習を抑制するというものです。
典型例が、損失関数に重みの二乗和(L2ノルムの二乗)を加えるL2正則化(L2 regularization)です。
ここで、は正則化の効果の強さを制御するパラメータです。
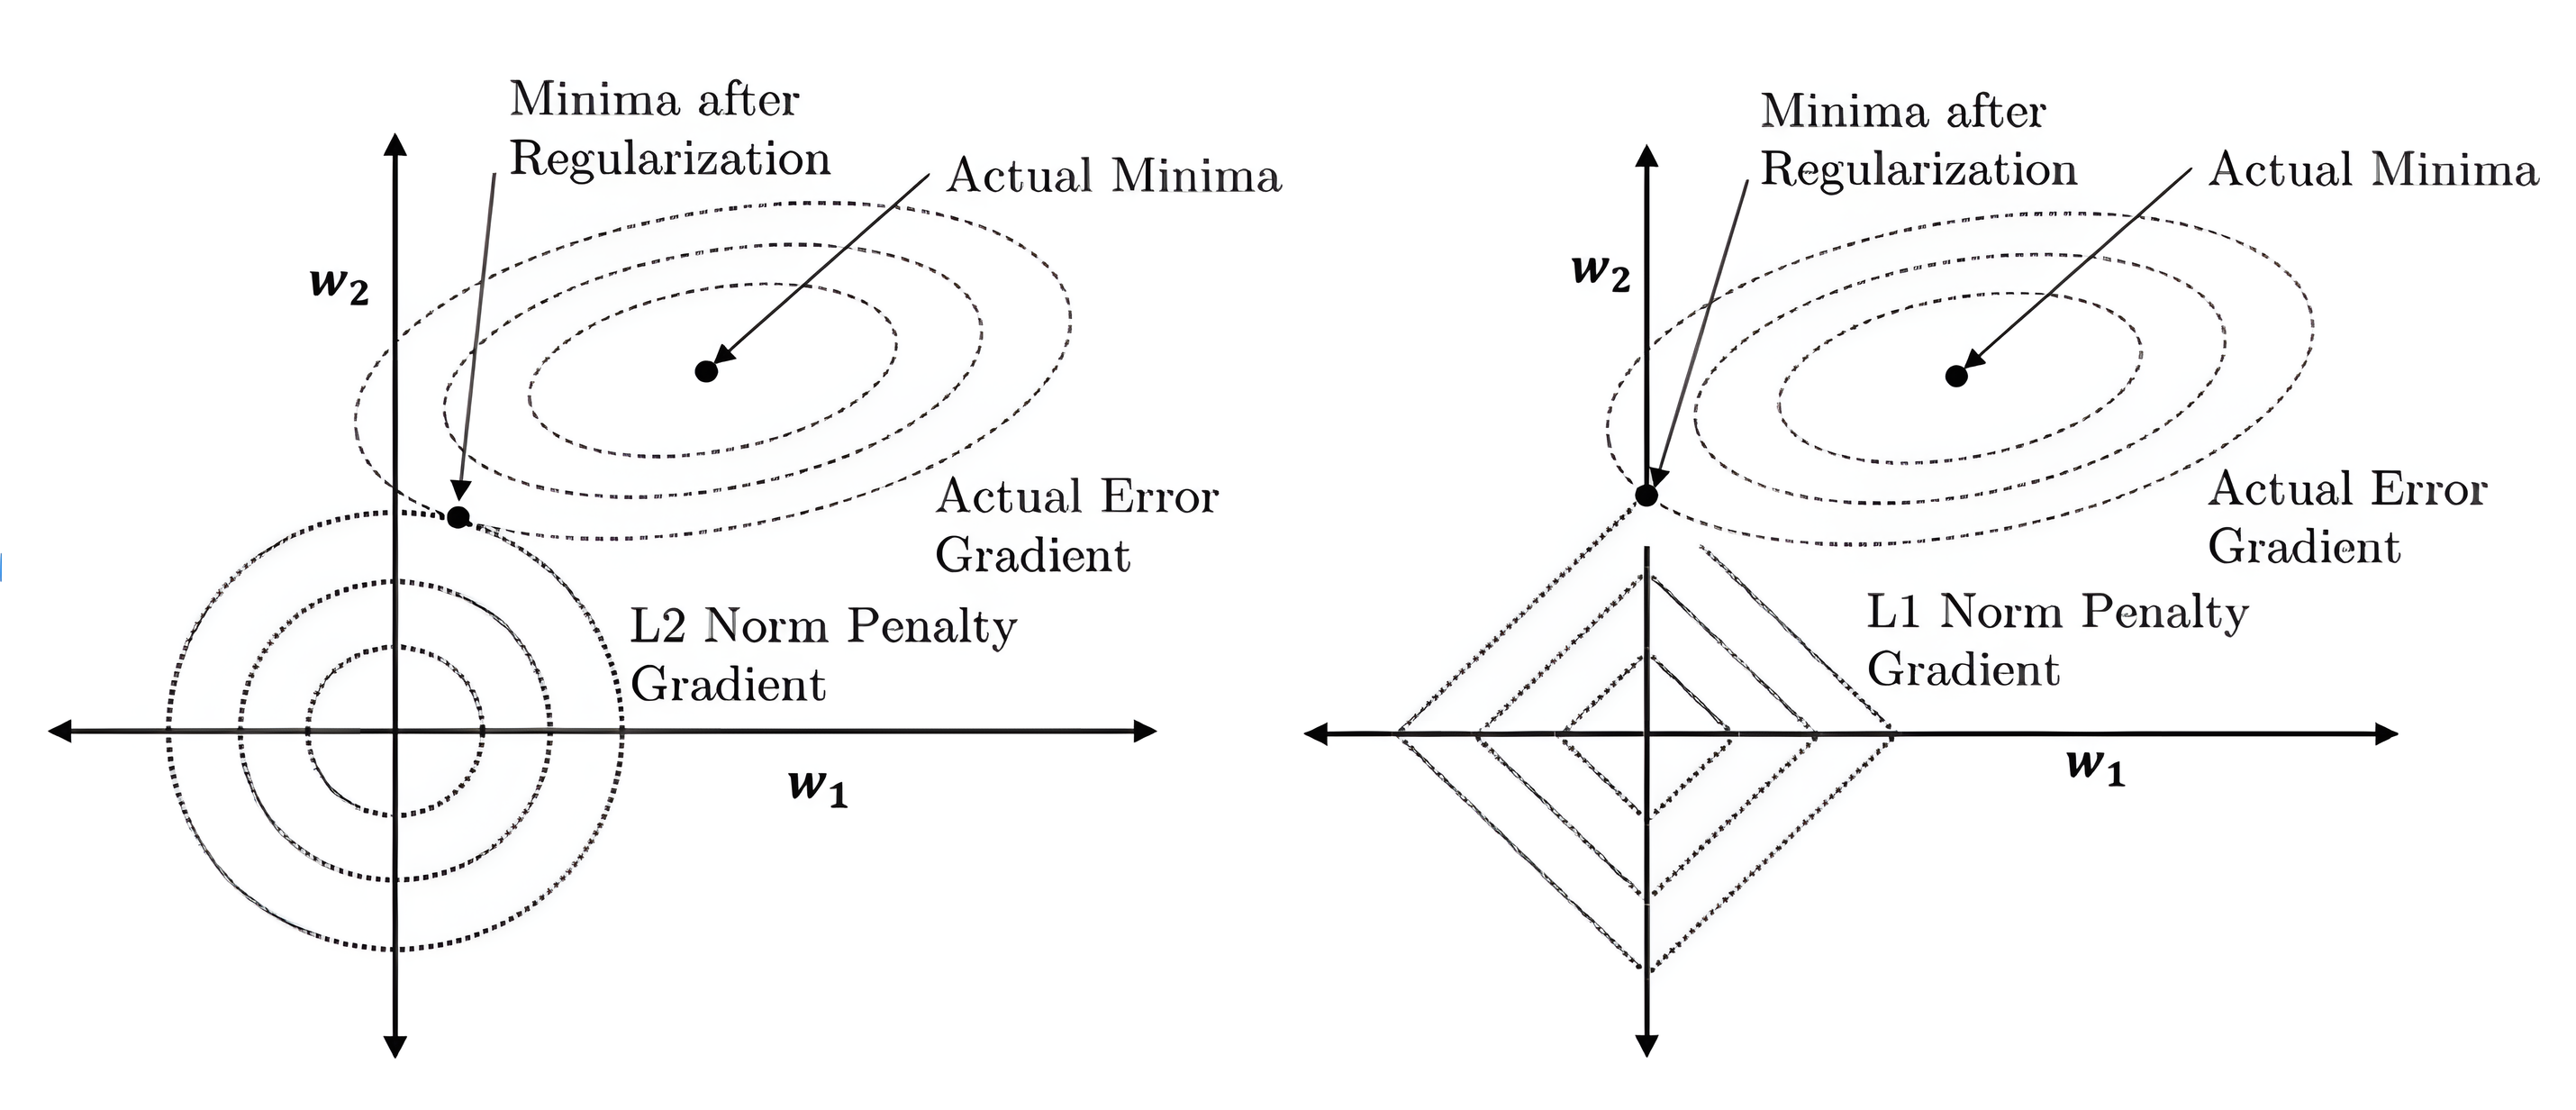
つまり、損失関数にを加算します。はペナルティとして、重みの大きさの二乗に比例して大きくなるため、重みが大きくなることを抑制することができます。
このペナルティの勾配はなので、学習率をとすると、勾配降下法の更新式は
となり、毎回の更新で重みが倍に縮小(減衰)されます。ここではペナルティ項を除いた損失です。このことから、この方法は重みの減衰(weight decay)とも呼ばれます。
2.2Dropout
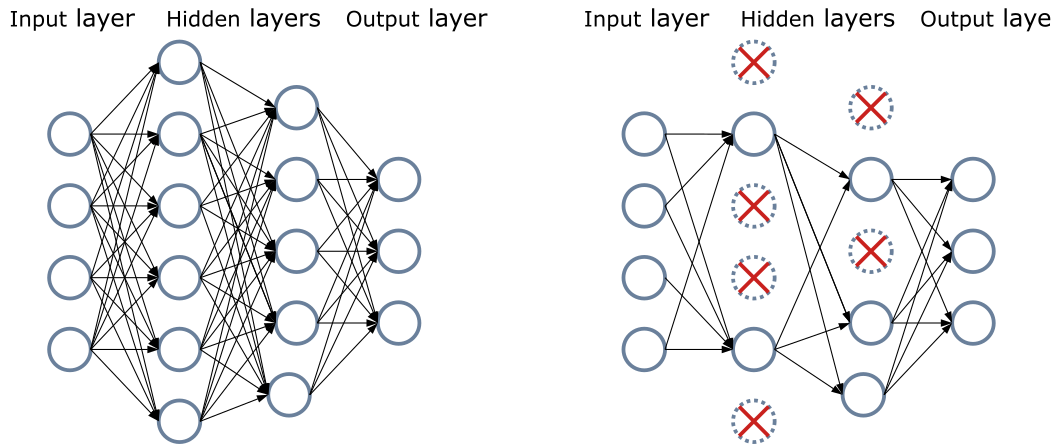
Dropoutは、ネットワークの隠れ層のニューロンを学習時ランダムに選別して削除することで過学習を抑制する手法です。
Dropoutの狙いは、学習時ネットワークの自由度を強制的に小さくし、過学習を避けることです。
またこうすることは、Dropoutによってニューロンをランダムに無効化した、重みを共有する多数のネットワークを学習し、推論時にそれらの結果を平均するのと同様の効果があると考えられています。複数のネットワークの平均をとると推論の精度が一般的に向上することが知られており、Dropoutはこれと同じ効果をより小さい計算コストで実現していると考えることができます。
なお、推論時にはDropoutを行わず、すべてのニューロンを使用します。学習時にニューロンを無効化する割合をとすると、学習時と推論時で出力のスケールが揃うように、推論時に出力を倍するか、学習時に残ったニューロンの出力を倍します。
3学習率の制御
ニューラルネットワークの学習では、学習率の値が重要になります。学習率が大きくなりすぎると学習は収束せず、小さくしすぎると学習が非常に遅くなる、または局所的な最適解にとどまってしまい、真の最適解にたどり着けない可能性があります。
3.1モメンタム
SGDにおいてのパラメータ更新を安定化し、収束性を改善するモメンタム(momentum)という方法があり、SGDではほとんど常に採用されます。
モメンタムは、重みを更新する際、重みの修正量に前回の修正量の何割かを加算する方法です。つまり、ミニバッチに対する重みの修正量をと書くと、ミニバッチに対する更新を
と定めます。ここで、は学習率、は前回の修正量をどれだけ残すかを決める係数(モメンタム係数)です。
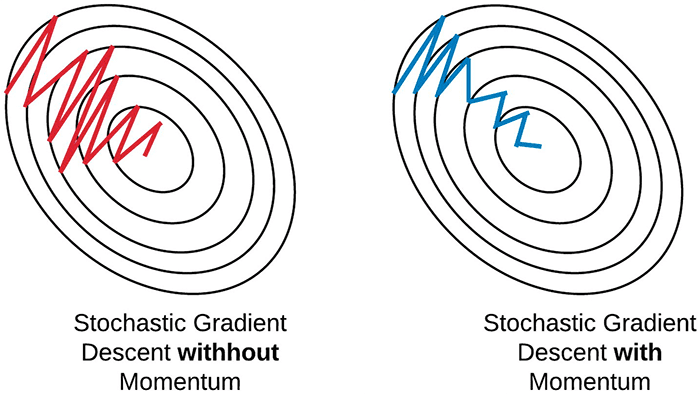
モメンタム法は、過去の勾配の移動平均を蓄積し、持続的にその勾配の方向性を進むようにします。これにより、より効率的に最小値を探索できるようになります。
3.2更新幅の適応的調整
学習率を、学習の開始から終了まで固定したままにすることは稀で、多くの場合時間と共に変化させます。重みの更新幅を適応的に調節する方法として、AdaGradという方法があります。
AdaGradは、パラメータの要素ごとに適応的に学習率を調整しながら学習を行う手法です。
AdaGradの更新方法を数式で表しますと
ここで、は、学習開始から現在に至る全更新について、勾配の二乗を加算したものです。(は行列要素ごとの掛け算を意味します。の乗算も要素ごとに行い、は0除算を避けるための小さな値で、例えば10-7です)
そして、パラメータを更新する際に、を乗算することで、学習のスケールを調整します。
この調整により、これまでの勾配の二乗和が大きい要素(大きく更新されてきた要素)ほど学習率が小さくなり、二乗和が小さい要素ほど学習率が大きく保たれます。
AdaGradでの更新では、学習が進むほど、更新度合いは小さくなります。つまり、勾配の累積によって自動的に学習率が調整されます。初期学習率を適切に設定すれば、後の調整を大幅に減らすことができ、異なるパラメータに対して異なるスピードで学習を進めることができます。
3.3Adam
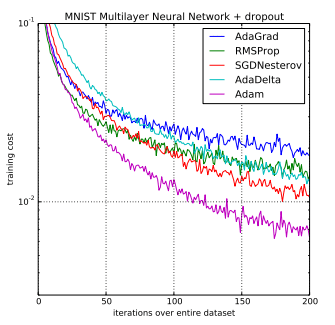
Adamは、モメンタムと、RMSPropと同様に勾配の二乗の指数移動平均で学習率を適応的に調整する方法を組み合わせたもので、実際によく使われている方法になります。
ここでは、詳しい理論の説明は省きますが、直感的には、モメンタム法とAdaGrad系の手法の利点を組み合わせることで、効率的にパラメータ空間を探索することが期待されます。
さらに、AdamWという手法もあります。Adamで損失にL2正則化項を加えることは重みの減衰と等価ではないため、AdamWでは重みの減衰を勾配に基づく更新から切り離して(decoupled weight decay)適用します。これがより良い結果をもたらす場合があり、BERTなどのTransformer系モデルの学習でもよく用いられます。