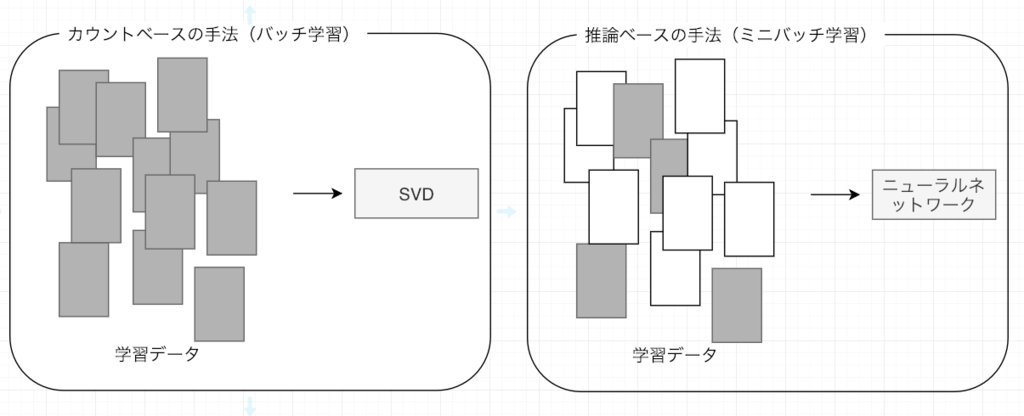
前章では、「カウントベースの手法」によって単語分散表現を得ました。具体的には、単語の共起行列を作り、その行列に対してSVDを適用することで、密なベクトル(単語分散表現)を獲得したのです。
しかし、カウントベースの手法にはいくつかの問題点があります。
大規模なコーパスを扱う場合、巨大な共起行列に対してSVDを計算することが難しい。
コーパスの全体から一回の学習で単語分散表現を獲得していますので、新しい単語が追加される場合、再度最初から学習を行う必要があり、単語分散表現更新の効率が低い。
「カウントベースの手法」に代わる強力な手法として「推論ベース」の手法が挙げられます。特に、Mikolov et al. (2013)によって提案されたword2vecの有用性が多くの自然言語処理タスクにおいて示されてきたのです。
本章では、word2vecの仕組みについて説明し、それを実装することで理解を深めます。
1推論ベース手法とニューラルネットワーク
推論ベースの手法は、ミニバッチで学習する形で、ニューラルネットワークを用いて、重みを繰り返し更新することで単語分散表現を獲得します。
1.1推論ベース手法の設計
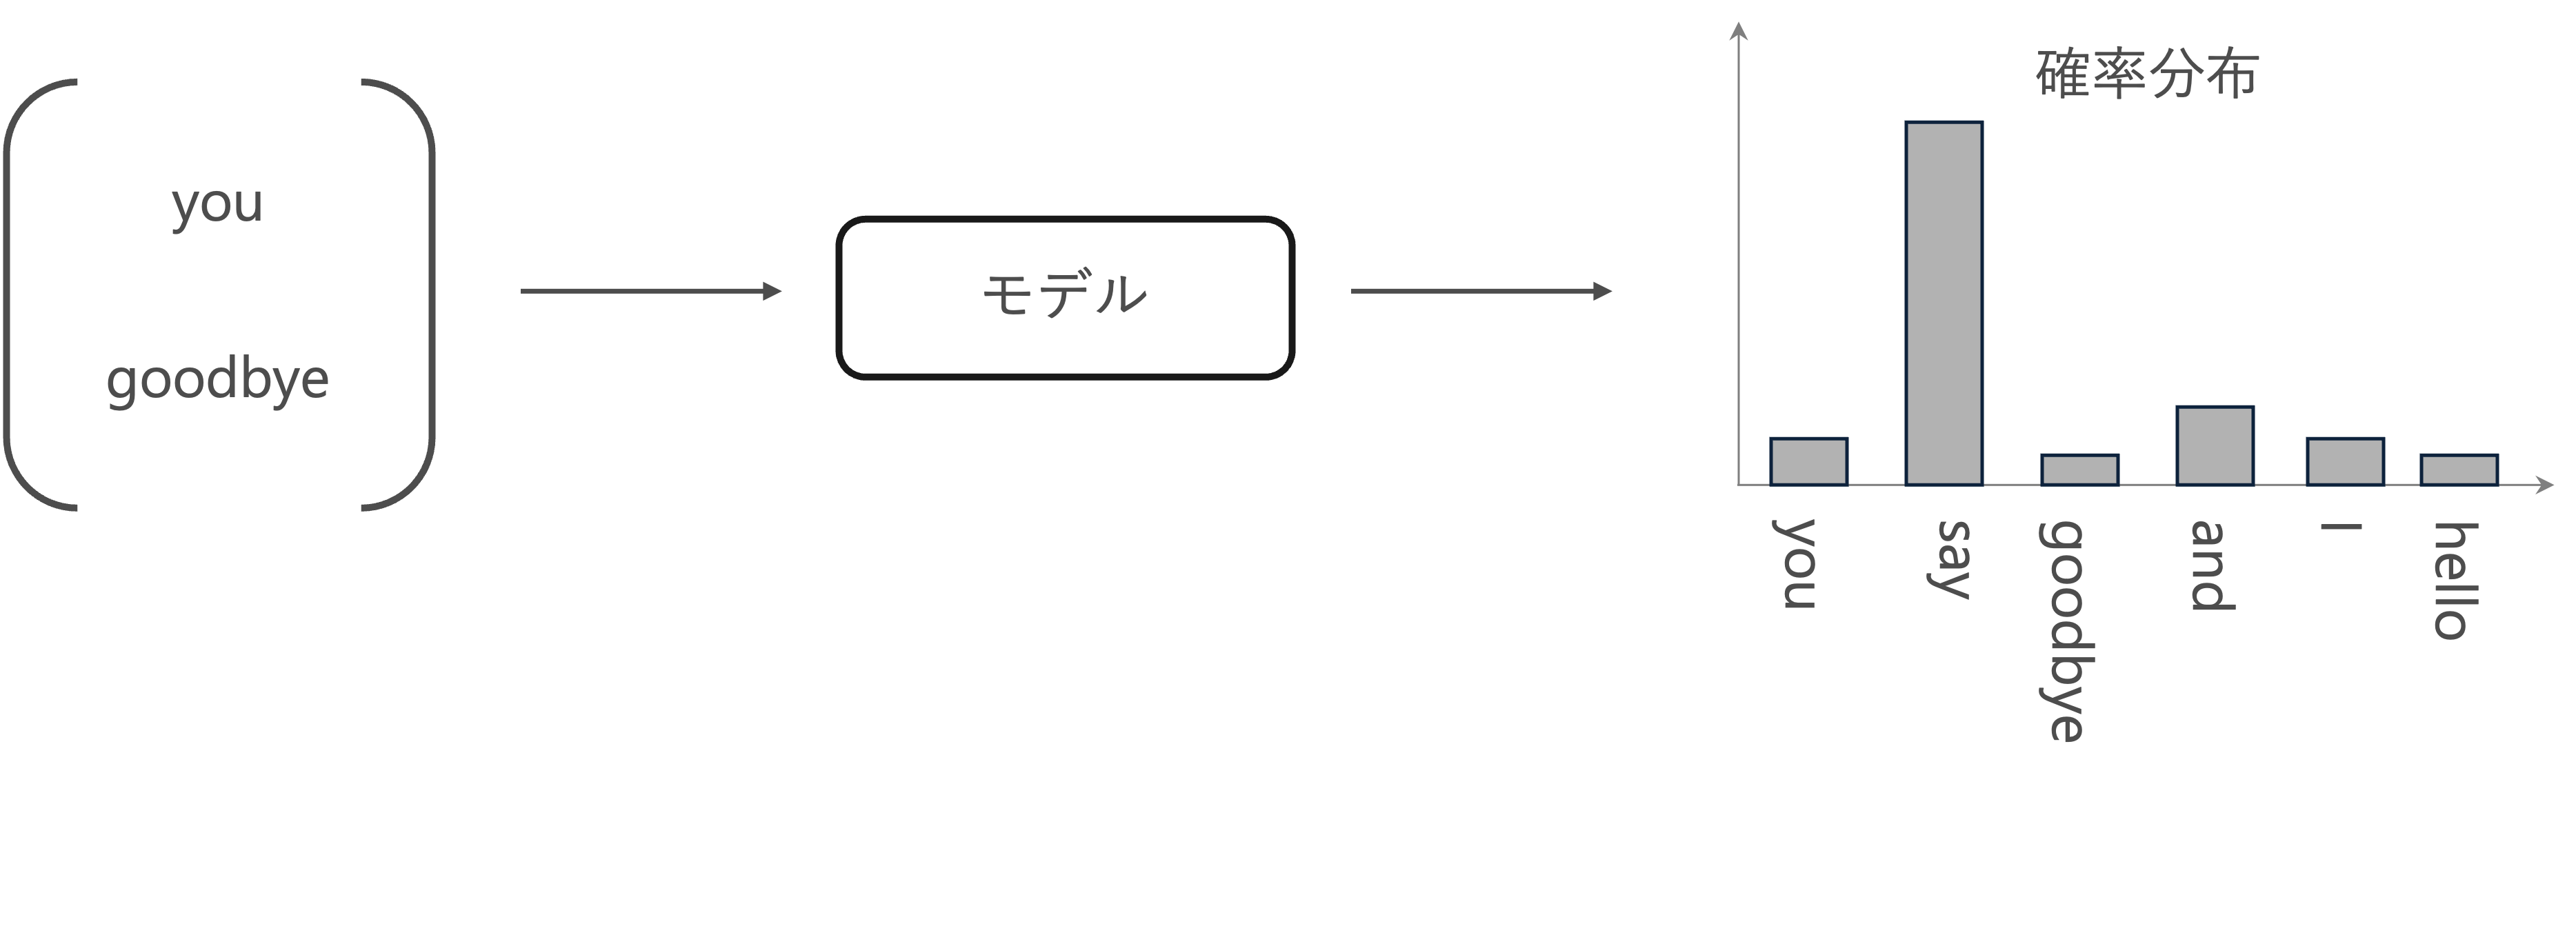
推論ベース手法では、you 【?】 goodbye and I say hello .のような、周囲の単語が与えられたときに、【?】にどのような単語が出現するのかを推測する推論問題を繰り返し解くことで、単語の出現パターンを学習します。
つまり、コンテキスト情報を入力として受け取り、各単語の出現する確率を出力する「モデル」を作成することが目標です。ここで、正しい推測ができるように、コーパスを使って、ニューラルネットワークモデルの学習を行います。そして、その学習の結果として、単語の分散表現を得られます。
推論タスク
1.2one-hot表現
ニューラルネットワークで単語を処理するには、それを「固定長のベクトル」に変換する必要があります。
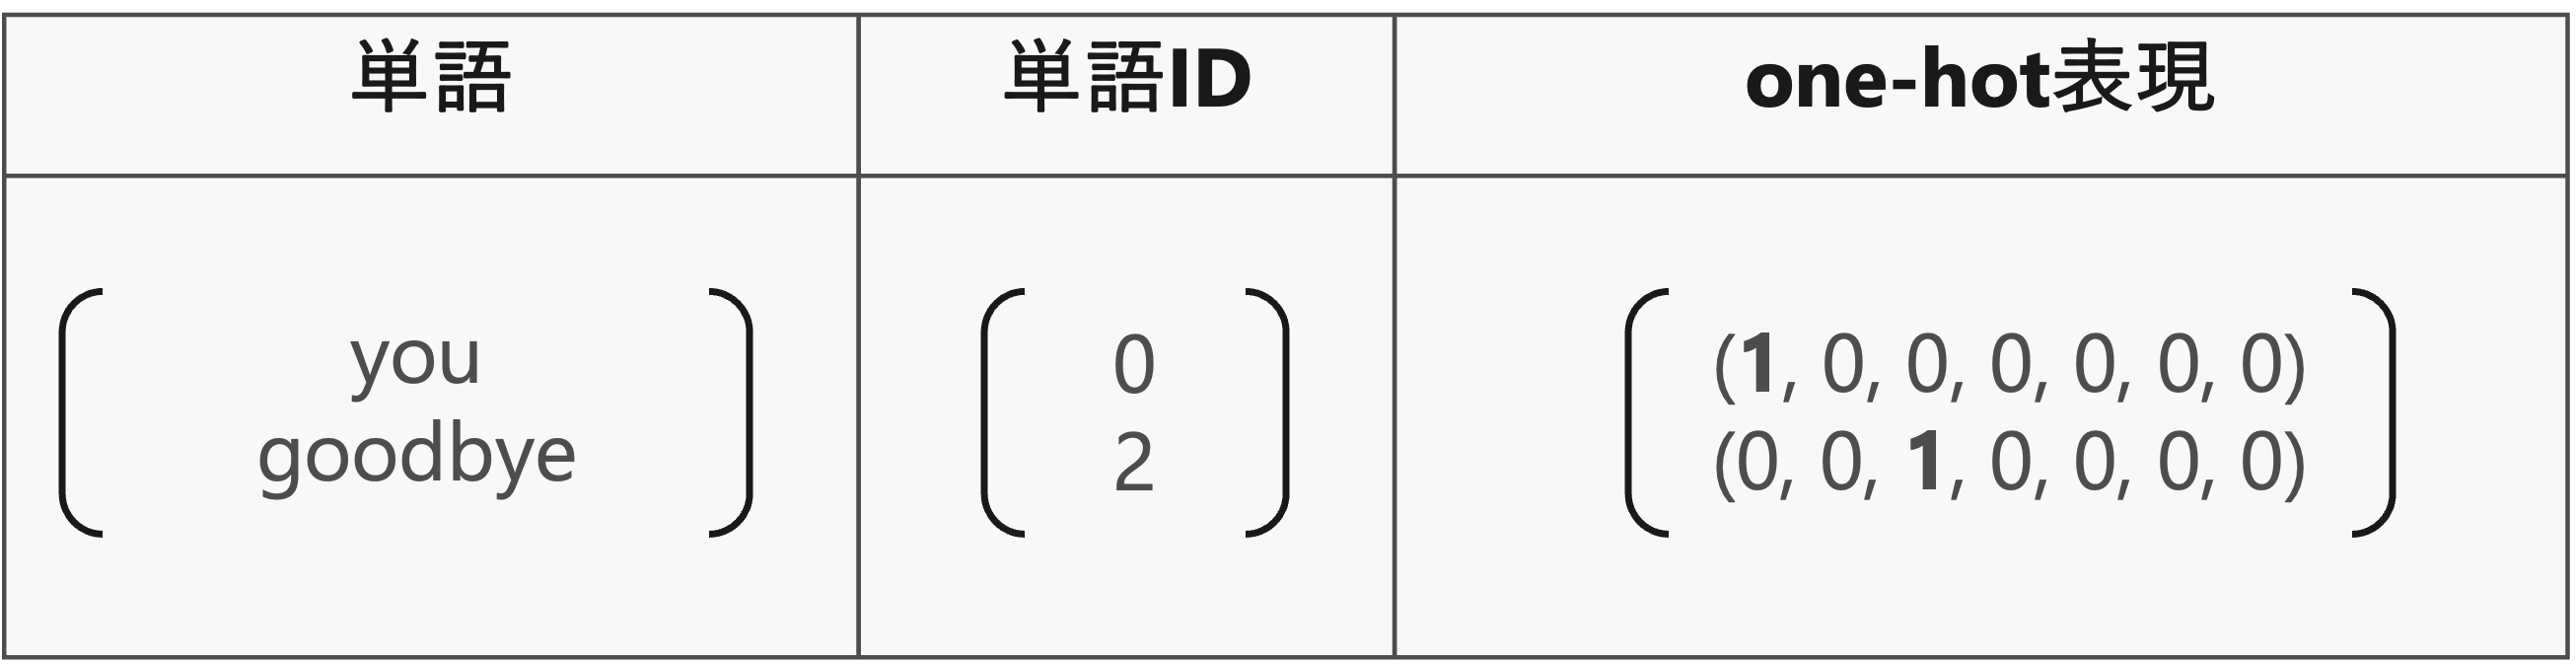
そのための方法の一つは、単語をone-hot表現へと変換することです。one-hot表現とは、ベクトルの要素の中で一つだけが1で、残りは全て0であるようなベクトルのことです。
単語をone-hot表現に変換するには、語彙数分の要素を持つベクトルを用意して、単語IDの該当する箇所を1に、残りは全て0に設定します。
1.3CBOW(continuous bag-of-words)モデル
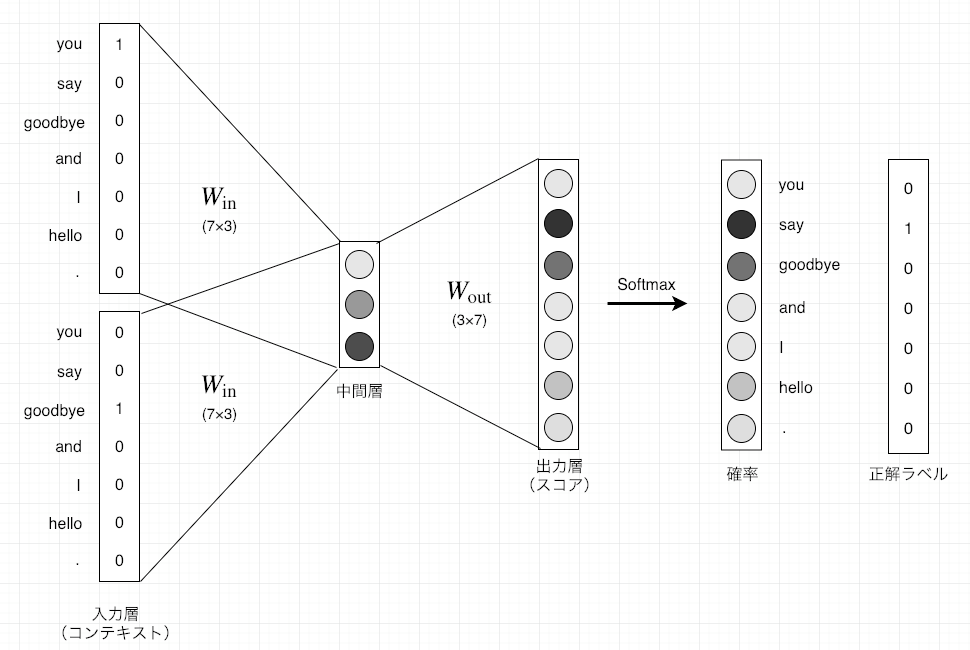
CBOWモデルは、コンテキストからターゲットを推測することを目的としたニューラルネットワークです。このCBOWモデルで、できるだけ正確な推測ができるように訓練することで、単語の分散表現を取得することができます。
ここで、例として、コンテキスト["you","goodbye"]からターゲット"say"を予測するタスクを考えます。
1.3.1入力層から中間層(エンコード)
one-hotエンコーディングで、単語を固定長のベクトルに変換することができます。
単語をベクトルで表すことができれば、そのベクトルはニューラルネットワークを構成する「レイヤ」によって処理することができるようになりました。
コンテキストを、重みをとし、それぞれ次の形状とします。
コンテキストの要素数(列数)と重みの行数が、単語の種類数に対応します。
コンテキスト(単語)はone-hot表現として扱うため、例えば「you」の場合は
とすることで、単語「you」を表現できます。
重み付き和は、行列の積で求められます。
の計算を詳しく見ると、次のようになります。
コンテキストと重みの対応する(同じ単語に関する)要素を掛けて、全ての単語で和をとります。しかしコンテキストは、以外の要素が0なので、対応する重みの値の影響は消えてしまいます。または1なので、対応する重みの値がそのまま中間層のニューロンに伝播します。
残りの2つの要素も同様に計算できるので、重み付き和
は、単語「you」に関する重みの値となります。
import numpy as np

# 適当にコンテキスト(one-hot表現)を指定
c = np.array([[1, 0, 0, 0, 0, 0, 0]])
print(f"コンテキストの形状:{c.shape}")

# 重みをランダムに生成
W = np.random.randn(7, 3)
print(f"重み\n{W}")

# 重み付き和を計算
h = np.dot(c, W)
print(f"重み付き和\n{h}")
print(f"重み付き和の形状:{h.shape}")
コンテキストの形状:(1, 7)
重み
[[ 0.06783164 -0.80640223 -0.77462623]
[-0.23186237 0.17269022 -0.41683942]
[ 0.29064795 0.09633413 2.16713912]
[ 0.49322236 -1.09178806 -0.00444333]
[ 1.48199498 -0.64959851 0.39150032]
[ 1.69079835 -0.53560302 0.74973898]
[ 0.87951791 -0.72085047 1.64067938]]
重み付き和
[[ 0.06783164 -0.80640223 -0.77462623]]
重み付き和の形状:(1, 3)
コンテキストに複数の単語がある場合、入力層も複数になります。このとき、中間層にあるニューロンは、各入力層の全結合による変換後の値が平均されたものになります。
中間層のニューロンの数を入力層よりも減らすことによって、中間層には、単語を予測するために必要な情報が"コンパクト"に収められて、結果としては密なベクトル表現が得られます。このとき、この中間層の情報は、人間には理解できない「ブラックボックス」のような状態になります。この作業は、「エンコード」と言います。
1.3.2中間層から出力層(デコード)
中間層の情報から目的の結果を得る作業は、「デコード」と言います。ここでは、中間層のニューロンの値を各単語に対応した値になるように、つまり要素(行)数が単語の種類数となるように再度変換したものを、CBOWモデルの出力とします。
出力層の重みを
とします。行数が中間層のニューロン数、列数が単語の種類数になります。
出力層も全結合層とすると、最終的な出力は
例えば、「you」に関する要素の計算は、
コンテキストに対応する入力層の重みの平均と「you」に関する出力の重みの積になります。
他の要素(単語)についても同様に計算できるので、最終的な出力は
となります。
ここで、出力層の各ニューロンの値は各単語に対応し、「スコア」と呼ばれます。
「スコア」の値が高ければ高いほど、それに対応する単語の出現確率も高くなり、ターゲットの単語であるとして採用します。そのため、スコアを求める処理を推論処理と言います。
import torch
import torch.nn as nn
import numpy as np

# Define the context data
c0 = torch.tensor([[1, 0, 0, 0, 0, 0, 0]], dtype=torch.float32) # you
c1 = torch.tensor([[0, 0, 1, 0, 0, 0, 0]], dtype=torch.float32) # goodbye

# Initialize weights randomly
W_in = torch.randn(7, 3, requires_grad=False)  # Input layer weights
W_out = torch.randn(3, 7, requires_grad=False) # Output layer weights

# Define the layers using PyTorch's functional API
def in_layer(x, W):
    return torch.matmul(x, W)

def out_layer(h, W):
    return torch.matmul(h, W)

# Forward pass through the input layers
h0 = in_layer(c0, W_in) # you
h1 = in_layer(c1, W_in) # goodbye
h = 0.5 * (h0 + h1)

# Forward pass through the output layer (scores)
s = out_layer(h, W_out)

# Print the outputs
h0, h1, h, torch.round(s, decimals=3)
(tensor([[ 0.6297, -0.8924, 0.7035]]),
tensor([[-0.9046, -0.7538, 0.7135]]),
tensor([[-0.1375, -0.8231, 0.7085]]),
tensor([[-0.1280, 0.1380, -1.1100, -0.5470, -1.1300, 0.1390, -0.5510]]))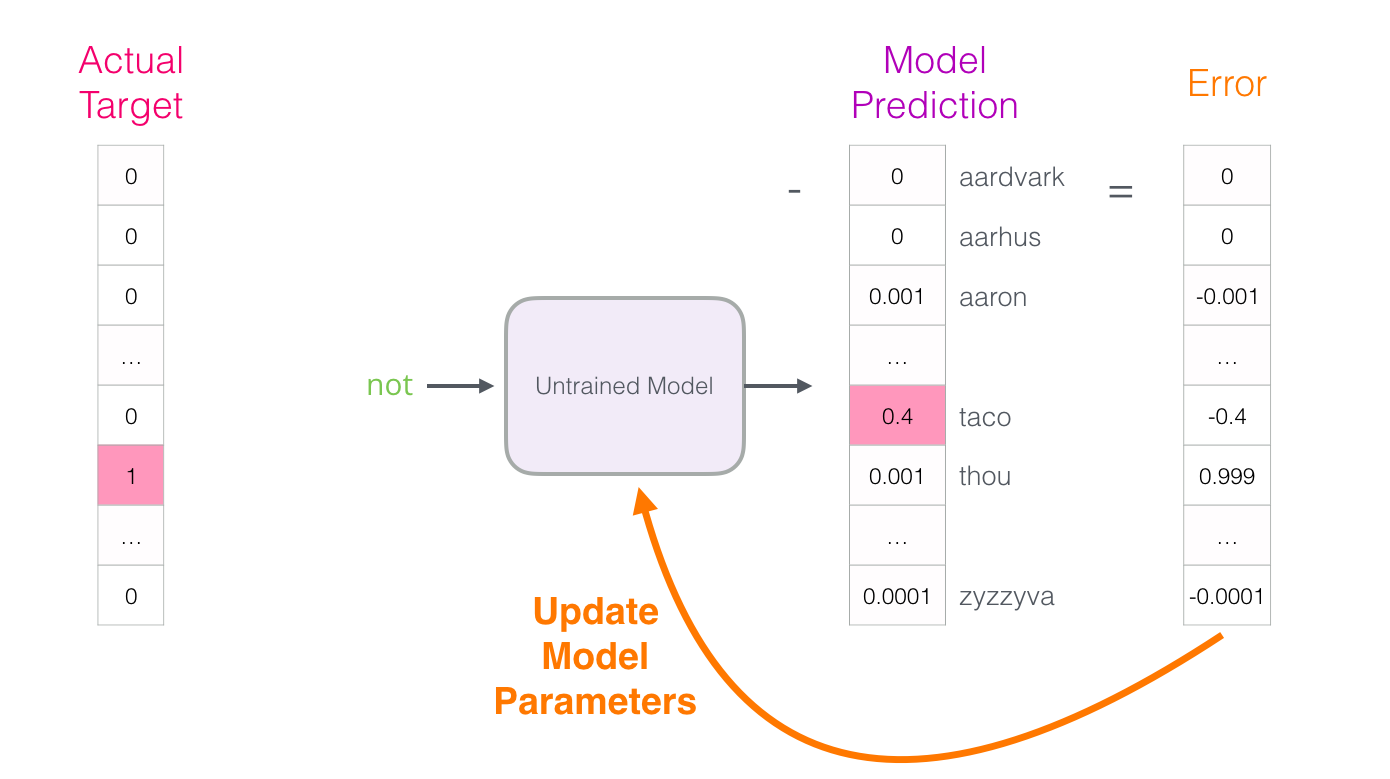
正解は「say」として、Softmax関数によってスコアsを確率として扱えるように変換し、そして、正規化した値と教師ラベルを用いて損失を求めなさい。
正解は「say」の場合、教師ラベルは[0, 1, 0, 0, 0, 0, 0]になります。
1.3.3word2vecの重みと分散表現
与えられたコンテキストに対して単語を予測するときに、「良い重み」のネットワークがあれば、「確率」を表すニューロンにおいて、正解に対応するニューロンが高くなっていることが期待できます。そして、大規模コーパスを使って得られる単語の分散表現は、単語の意味や文法のルールにおいて、人間の直感と合致するケースが多く見られます。
word2vecモデルの学習で行うことが、正しい予測ができるように重みを調整することです。つまり、「コンテキストから、出現する単語」を予測するという偽タスクをニューラルネットで解いてきましたが、目的はニューラルネットの重みを求めることになります。
もっと具体的に言えば、word2vecで使用されるネットワークには二つの重みがあります。それは、入力層の重みと、出力層の重みです。それでは、どちらの重みを使えば良いでしょうか?
入力側の重みを利用する
出力側の重みを利用する
二つの重みの両方を利用する
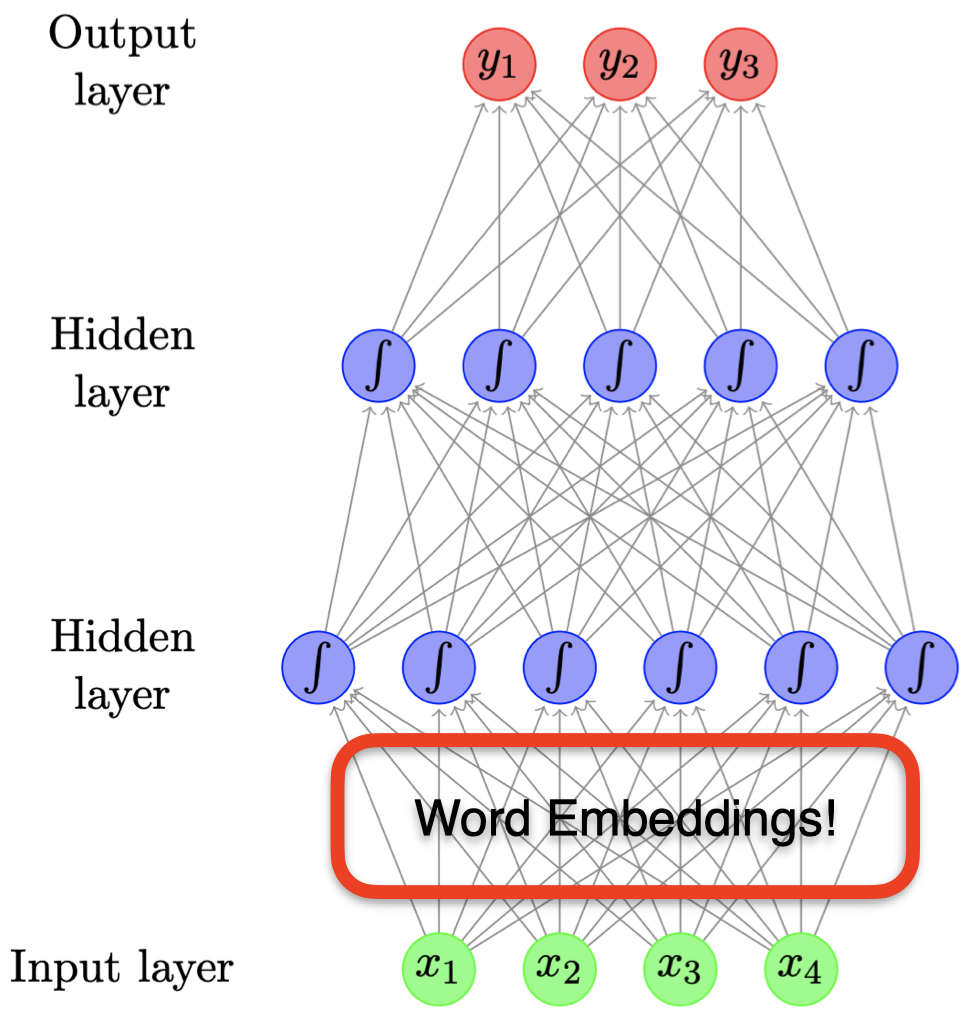
word2vecモデルに関しては、多くの研究や応用例で、入力層の重みを単語のベクトル表現として使用されており、良好なパフォーマンスを示しています。
2word2vecモデルの実装
2.1学習データの準備
2.1.1コンテキストとターゲット
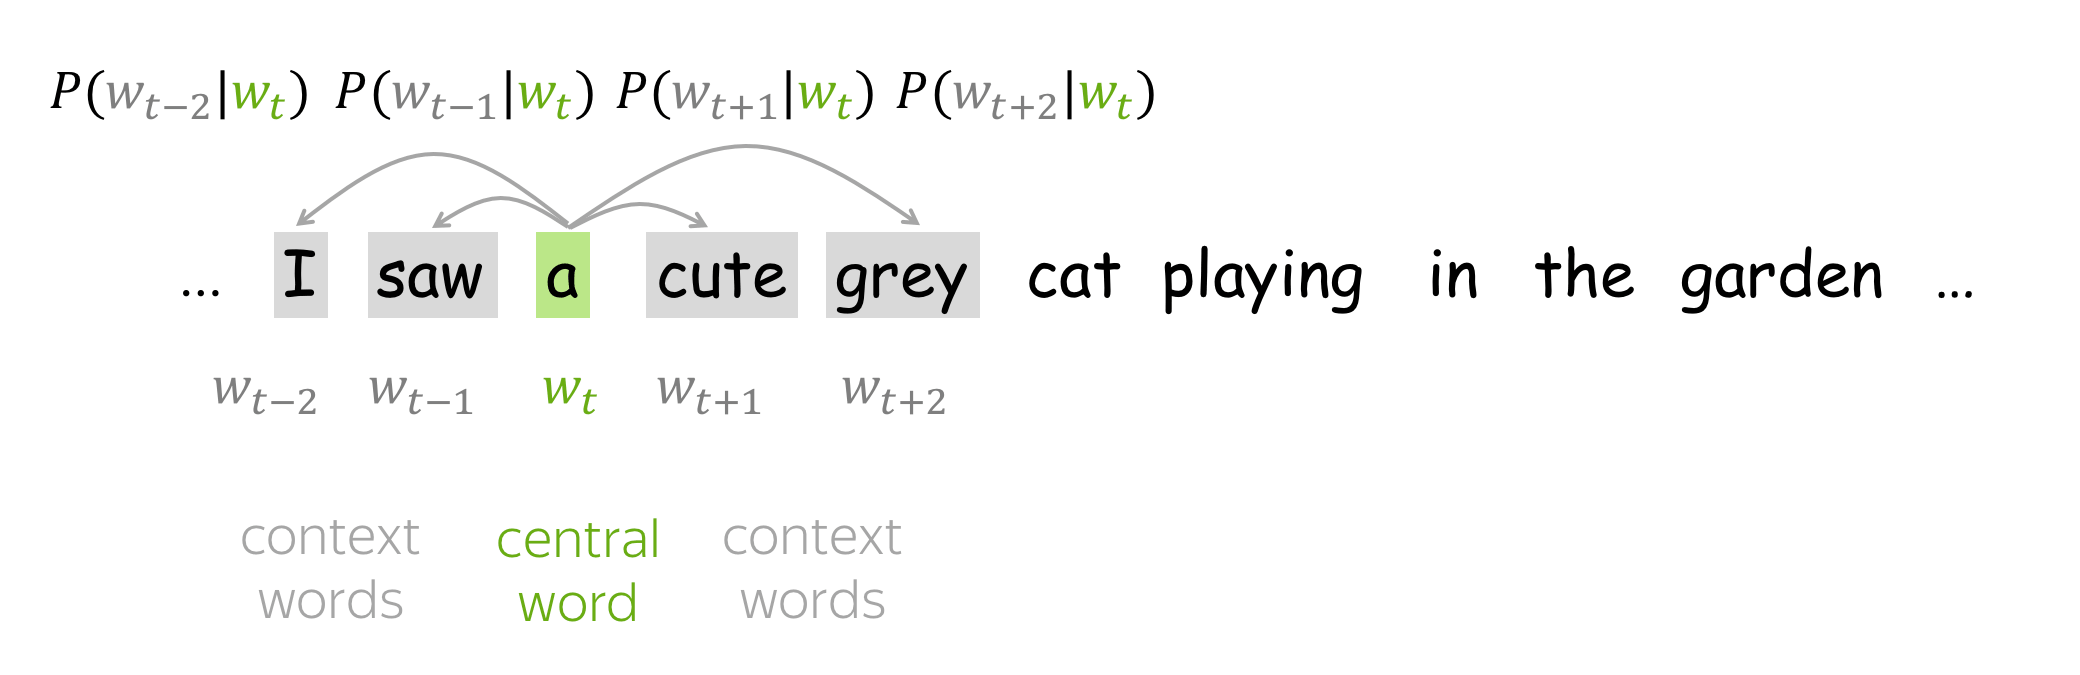
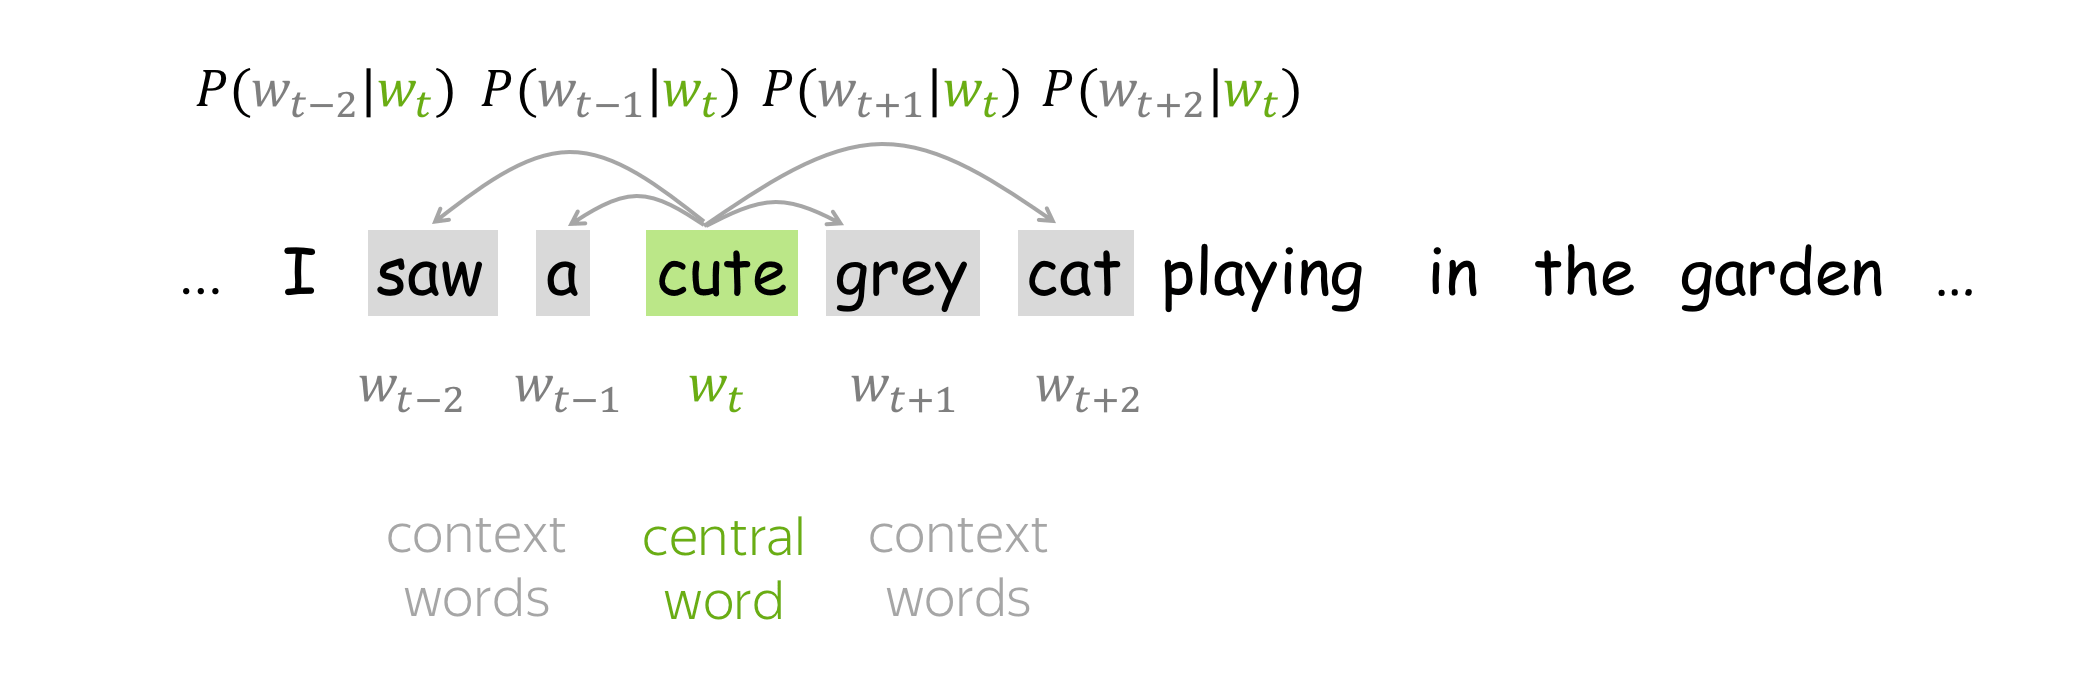
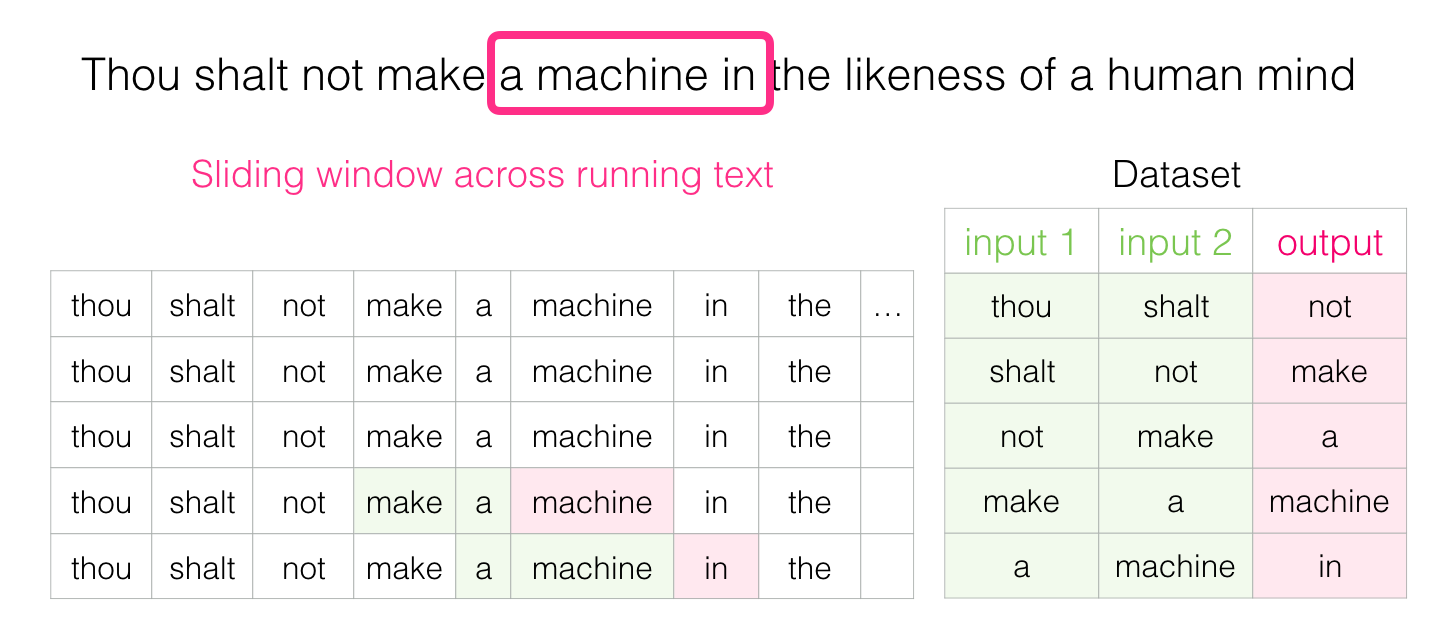
word2vecモデルのためのニューラルネットワークでは、「コンテキスト」を入力した時に、「ターゲット」が出現する確率を高くなるように学習を行います。
そのため、コーパスから「コンテキスト」と「ターゲット」が対応するデータを作成する必要があります。
# 前処理関数の実装
def preprocess(text):
    # 前処理
    text = text.lower() # 小文字に変換
    text = text.replace('.', ' .') # ピリオドの前にスペースを挿入
    words = text.split(' ') # 単語ごとに分割

    # ディクショナリを初期化
    word_to_id = {}
    id_to_word = {}

    # 未収録の単語をディクショナリに格納
    for word in words:
        if word not in word_to_id: # 未収録の単語のとき
            # 次の単語のidを取得
            new_id = len(word_to_id)

            # 単語をキーとして単語IDを格納
            word_to_id[word] = new_id

            # 単語IDをキーとして単語を格納
            id_to_word[new_id] = word

    # 単語IDリストを作成
    corpus = [word_to_id[w] for w in words]

    return corpus, word_to_id, id_to_word
# テキストを設定
text = 'You say goodbye and I say hello.'
# 前処理
corpus, word_to_id, id_to_word = preprocess(text)
print(word_to_id)
print(id_to_word)
print(corpus){'you': 0, 'say': 1, 'goodbye': 2, 'and': 3, 'i': 4, 'hello': 5, '.': 6}
{0: 'you', 1: 'say', 2: 'goodbye', 3: 'and', 4: 'i', 5: 'hello', 6: '.'}
[0, 1, 2, 3, 4, 1, 5, 6]
テキストの単語を単語IDに変換したcorpusからターゲットを抽出します。
ターゲットはコンテキストの中央の単語なので、corpusの始めと終わりのウインドウサイズ分の単語は含めません。
# ウインドウサイズを指定
window_size = 1

# ターゲットを抽出
target = corpus[window_size:-window_size]
print(target)
[1, 2, 3, 4, 1, 5]
ターゲットの単語に対して、for文で前後ウィンドウサイズの範囲の単語を順番に抽出しcsに格納します。
つまりウィンドウサイズを1とすると、corpusにおけるターゲットのインデックスidxに対して、1つ前(idx - window_size)から1つ後(idx + window_size)までの範囲の単語を順番にcsに格納します。ただしターゲット自体の単語はコンテキストに含めません。
# コンテキストを初期化(受け皿を作成)
contexts = []

# 1つ目のターゲットのインデックス
idx = window_size

# 1つ目のターゲットのコンテキストを初期化(受け皿を作成)
cs = []

# 1つ目のターゲットのコンテキストを1単語ずつ格納
for t in range(-window_size, window_size + 1):

    # tがターゲットのインデックスのとき処理しない
    if t == 0:
        continue

    # コンテキストを格納
    cs.append(corpus[idx + t])
    print(cs)

# 1つ目のターゲットのコンテキストを格納
contexts.append(cs)
print(contexts)
[0]
[0, 2]
[[0, 2]]
# コンテキストとターゲットの作成関数の実装
def create_contexts_target(corpus, window_size=1):

    # ターゲットを抽出
    target = corpus[window_size:-window_size]

    # コンテキストを初期化
    contexts = []

    # ターゲットごとにコンテキストを格納
    for idx in range(window_size, len(corpus) - window_size):

        # 現在のターゲットのコンテキストを初期化
        cs = []

        # 現在のターゲットのコンテキストを1単語ずつ格納
        for t in range(-window_size, window_size + 1):

            # 0番目の要素はターゲットそのものなので処理を省略
            if t == 0:
                continue

            # コンテキストを格納
            cs.append(corpus[idx + t])

        # 現在のターゲットのコンテキストのセットを格納
        contexts.append(cs)

    # NumPy配列に変換
    return np.array(contexts), np.array(target)
# コンテキストとターゲットを作成
contexts, targets = create_contexts_target(corpus, window_size=1)
print(contexts)
print(targets)[[0 2]
[1 3]
[2 4]
[3 1]
[4 5]
[1 6]]
[1 2 3 4 1 5]
2.2PyTorchでCBOWモデルの実装
import numpy as np
import torch
import torch.optim as optim
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, Dataset
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')2.2.1Embeddingレイヤ
先ほど、理解しやすいone-hot表現でコンテキストを変換する方法を説明しましたが、大規模なコーパスで学習する際、one-hot表現の次元数も大きくなって、非効率な学習の原因になります。
ただ、one-hot表現による計算は、単に行列の特定の行を抜き出すことだけですから、同じ機能を持つレイヤで入れ替えることは可能です。このような、重みパラメータから「単語IDに該当する行(ベクトル)」を抜き出すためのレイヤは「Embeddingレイヤ」と言います。
PyTorchで提供されるモジュールnn.Embeddingを使うと、簡単にEmbeddingレイヤを実装することができます。
例えば、語彙に6つの単語があり、各埋め込みベクトルの次元数を3に設定した場合、nn.Embeddingの定義は以下のようになります。
embedding_layer = nn.Embedding(6, 3)もしインデックス2のトークンの埋め込みを取得したい場合、次のようにします:
inputs = torch.tensor([[1,2]], dtype=torch.long)
embedding = embedding_layer(inputs)
embedding
tensor([[[-0.1405, -0.8412, -0.3166],
[-0.2717, -0.2344, 0.5441]]], grad_fn=<EmbeddingBackward0>)埋め込みベクトルの和を取って、入力層から中間層までにエンコードの機能を実装できます。
out=torch.sum(embedding, dim=1)
out
tensor([[-0.4121, -1.0756, 0.2275]], grad_fn=<SumBackward1>)linear1 = nn.Linear(3, 6)F.log_softmax(linear1(out), dim=1)tensor([[-1.6742, -2.3260, -2.1915, -1.1772, -1.9379, -1.8908]],
grad_fn=<LogSoftmaxBackward0>)2.2.2ミニバッチ化データセットの作成
word2vecも含めて、深層学習によって学習を行う際には、ミニバッチ化して学習させることが一般的です。
PyTorchで提供されているDatasetとDataLoaderという機能を用いてミニバッチ化を簡単に実現できます。
2.2.2.1DataSet
Datasetは、元々のデータを全て持っていて、ある番号を指定されると、その番号の入出力のペアをただ一つ返します。クラスを使って実装します。
Datasetを実装する際には、クラスのメンバ関数として__len__()と__getitem__()を必ず作ります。
__len__()は、len()を使ったときに呼ばれる関数です。__getitem__()は、array[i]のようにインデックスを使って要素を参照するときに呼ばれる関数です。
class CBOWDataset(Dataset):
    def __init__(self, contexts, targets):
        self.contexts = contexts
        self.targets = targets

    def __len__(self):
        return len(self.targets)

    def __getitem__(self, idx):
        return self.contexts[idx], self.targets[idx]
# Convert contexts and targets to tensors
contexts_tensor = torch.tensor(contexts, dtype=torch.long).to(device)
targets_tensor = torch.tensor(targets, dtype=torch.long).to(device)
# Create the dataset
dataset = CBOWDataset(contexts_tensor, targets_tensor)print('全データ数:',len(dataset))
print('4番目のデータ:',dataset[3])
print('4~5番目のデータ:',dataset[3:5])全データ数: 6
4番目のデータ: (tensor([3, 1]), tensor(4))
4~5番目のデータ: (tensor([[3, 1],
[4, 5]]), tensor([4, 1]))
2.2.2.2DataLoader
torch.utils.dataモジュールには、データのシャッフルとミニバッチの整形に役立つDataLoaderというクラスが用意されています。
# Create the DataLoader
batch_size = 2  # You can adjust the batch size
data_loader = DataLoader(dataset, batch_size=batch_size, shuffle=True)
for data in data_loader:
print(data)[tensor([[1, 3],
[0, 2]]), tensor([2, 1])]
[tensor([[2, 4],
[3, 1]]), tensor([3, 4])]
[tensor([[1, 6],
[4, 5]]), tensor([5, 1])]
2.2.3CBOWモデルの構築
import numpy as np
import torch
import torch.optim as optim
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, Dataset
self.embeddings = nn.Embedding(vocab_size, embedding_size): 語彙の各単語に対してembedding_size次元のベクトルを割り当てる埋め込み層を作成します。self.linear1 = nn.Linear(embedding_size, vocab_size): 埋め込みベクトルを受け取り、語彙のサイズに対応する出力を生成します。embeds = self.embeddings(inputs):入力された単語のインデックスに基づいて、埋め込み層から対応するベクトルを取得します。
class SimpleCBOW(nn.Module):
    def __init__(self, vocab_size, embedding_size):
        super(SimpleCBOW, self).__init__()
        self.embeddings = nn.Embedding(vocab_size, embedding_size)
        self.linear1 = nn.Linear(embedding_size, vocab_size)

    def forward(self, inputs):
        embeds = self.embeddings(inputs)
        out = torch.sum(embeds, dim=1)
        out = self.linear1(out)
        # スコア(logits)をそのまま返す。softmaxはnn.CrossEntropyLossの内部で行われる
        return out
# パラメータの設定
embedding_size = 10
learning_rate = 0.01
epochs = 100
vocab_size = len(word_to_id)
# モデルのインスタンス化
model = SimpleCBOW(vocab_size, embedding_size).to(device)
loss_function = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=learning_rate)
# Training loop with batch processing
for epoch in range(epochs):
total_loss = 0
for i, (context_batch, target_batch) in enumerate(data_loader):
# Zero out the gradients from the last step
model.zero_grad()
# Forward pass through the model
logits = model(context_batch)
# Compute the loss
loss = loss_function(logits, target_batch)
# Backward pass to compute gradients
loss.backward()
# Update the model parameters
optimizer.step()
# Accumulate the loss
total_loss += loss.item()
# Log the total loss for the epoch
if epoch % 10 == 0:
print(f'Epoch {epoch}, Total loss: {total_loss}')Epoch 0, Total loss: 6.139737367630005
Epoch 10, Total loss: 4.7057578563690186
Epoch 20, Total loss: 3.722508132457733
Epoch 30, Total loss: 3.0618834495544434
Epoch 40, Total loss: 2.5887580513954163
Epoch 50, Total loss: 2.251922070980072
Epoch 60, Total loss: 2.0073779821395874
Epoch 70, Total loss: 1.8148369193077087
Epoch 80, Total loss: 1.6640116572380066
Epoch 90, Total loss: 1.5436910688877106
nn.CrossEntropyLossの使い方
nn.CrossEntropyLossターゲットラベルをクラスのインデックスとして受け取り、内部で必要な変換を行いますので、ターゲットをワンホットエンコーディングに変換する必要はありません。
なお、nn.CrossEntropyLossは内部でsoftmax(log-softmax)を適用するため、モデルの出力にはsoftmaxを適用せず、スコア(logits)をそのまま渡します。モデル側でlog_softmaxを適用する場合は、nn.NLLLossを組み合わせます。
モデルの入力層の重みが単語分散表現であり、単語 埋め込み次元数の形の行列になります。
model.embeddings.weight.shapetorch.Size([7, 10])word_embeddings = model.embeddings.weight.data
# 各単語とそれに対応する分散表現を表示
for word, idx in word_to_id.items():
vector = word_embeddings[idx].cpu().numpy()
print(f"Word: {word}")
print(f"Vector: {vector}\n")Word: you
Vector: [-0.9910462 -0.26103663 0.37548813 -0.8958604 0.4883364 -0.10967051
0.83219934 1.2695521 0.4894465 -0.93762267]
Word: say
Vector: [ 0.16747946 -0.39847788 1.0496353 -1.5360904 -1.5014437 0.4942124
0.34624904 -0.34384438 0.5449382 -0.3768147 ]
Word: goodbye
Vector: [-1.9509926 1.5140524 0.74627566 1.6006314 -0.6697169 -0.16869175
-0.16643491 -0.13721499 0.98251516 0.464983 ]
Word: and
Vector: [ 2.20343 0.95126253 -0.97306097 0.8715391 -0.16568483 0.20985529
-2.0275564 0.462676 -0.8142235 0.53176856]
Word: i
Vector: [ 0.4384659 -1.1122588 0.39310274 -1.0731715 -0.6900966 -2.290304
-1.7379956 -0.3933478 0.6740521 0.5169324 ]
Word: hello
Vector: [-0.73360014 0.9347052 -0.11820035 0.7009177 0.47436512 1.431984
-0.46498355 -0.5125341 0.70763314 -1.6589094 ]
Word: .
Vector: [-0.74944794 0.8782758 -0.31801623 -0.8320363 1.4819576 1.5980204
-1.5042956 -0.9542531 -1.1500387 1.3903668 ]
与えられたテキストを用いて、単語分散表現を学習しなさい。
window_sizeを2に設定しますbatch_sizeを10に設定します
“When forty winters shall besiege thy brow, And dig deep trenches in thy beauty’s field, Thy youth’s proud livery so gazed on now, Will be a totter’d weed of small worth held: Then being asked, where all thy beauty lies, Where all the treasure of thy lusty days; To say, within thine own deep sunken eyes, Were an all-eating shame, and thriftless praise. How much more praise deserv’d thy beauty’s use, If thou couldst answer ‘This fair child of mine Shall sum my count, and make my old excuse,’ Proving his beauty by succession thine! This were to be new made when thou art old, And see thy blood warm when thou feel’st it cold.”
3.2Negative Sampling
今まで紹介した学習の仕組みでは、正例(正しい答え)について学習を行いました。ここで、「良い重み」があれば、ターゲット単語についてSigmoidレイヤの出力は1に近づくことになります。
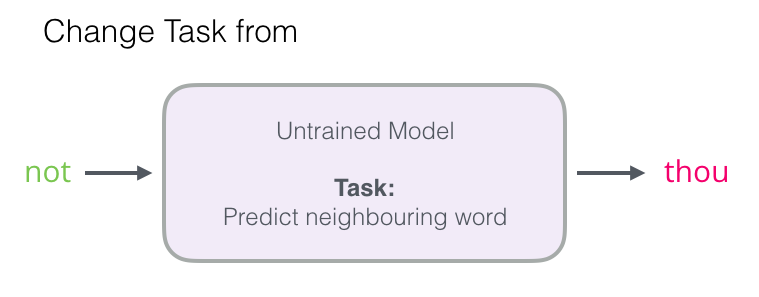
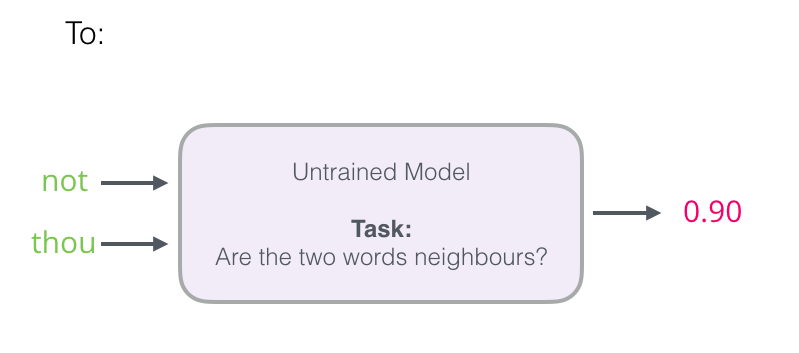
それだけでなく、本当に行いたいのは、コンテキストが与えられるときに、間違った単語を予測してしまう確率も低いことが望まれます。ただ、全ての誤った単語(負例)を対象として、学習を行うことは非効率であるので、そこで、負例をいくつかピックアップします。これが「Negative Sampling」という手法の意味です。
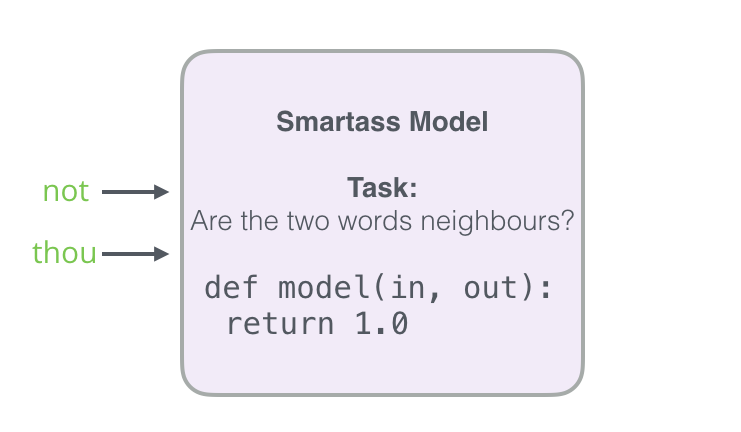
Negative Samplingでは、正例をターゲットとした場合の損失を求めると同時に、負例をいくつかサンプリングし、その負例に対しても同様に損失を求めます。そして、両者を足し合わせ、最終的な損失とします。このプロセスは、モデルが正しい単語を予測するだけでなく、不適切な単語を予測しない能力を同時に学習することを目的としています。
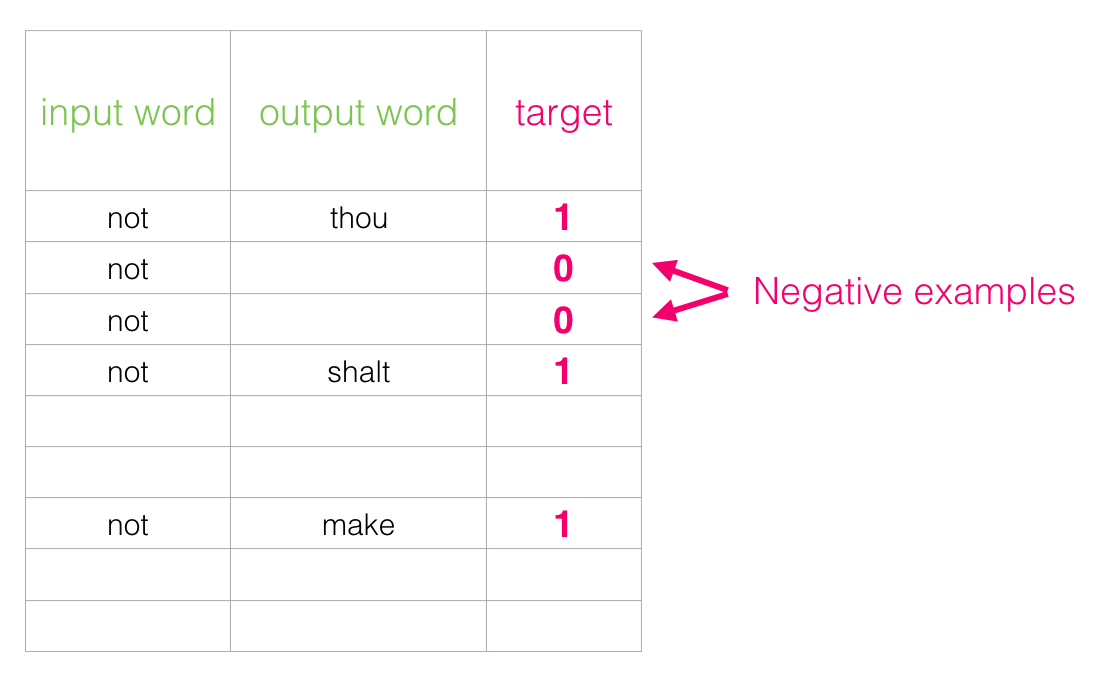
それでは、負例をどのようにサンプリングすべきですか?単純にランダムサンプリングの場合、高頻度の単語はサンプリングされやすく、低頻度の単語はサンプリングされにくく、珍しい単語や文脈に適切に対応できない原因になります。
この問題点を克服するために、word2vecで提案されるNegative Samplingでは、元となる確率分布に対して以下のように改良しました
0.75乗して調整することで、確率の低い単語に対してその確率を少しだけ高くすることができます。これにより、モデルはより現実的な言語パターンを学習し、実際の使用状況においてより正確な予測を行うことができます。
3.3Skip-gram
これまで見てきたCBOWモデルのほかに、word2vecを学習する方法として、Skip-gramと呼ばれる言語モデルが提案されています。
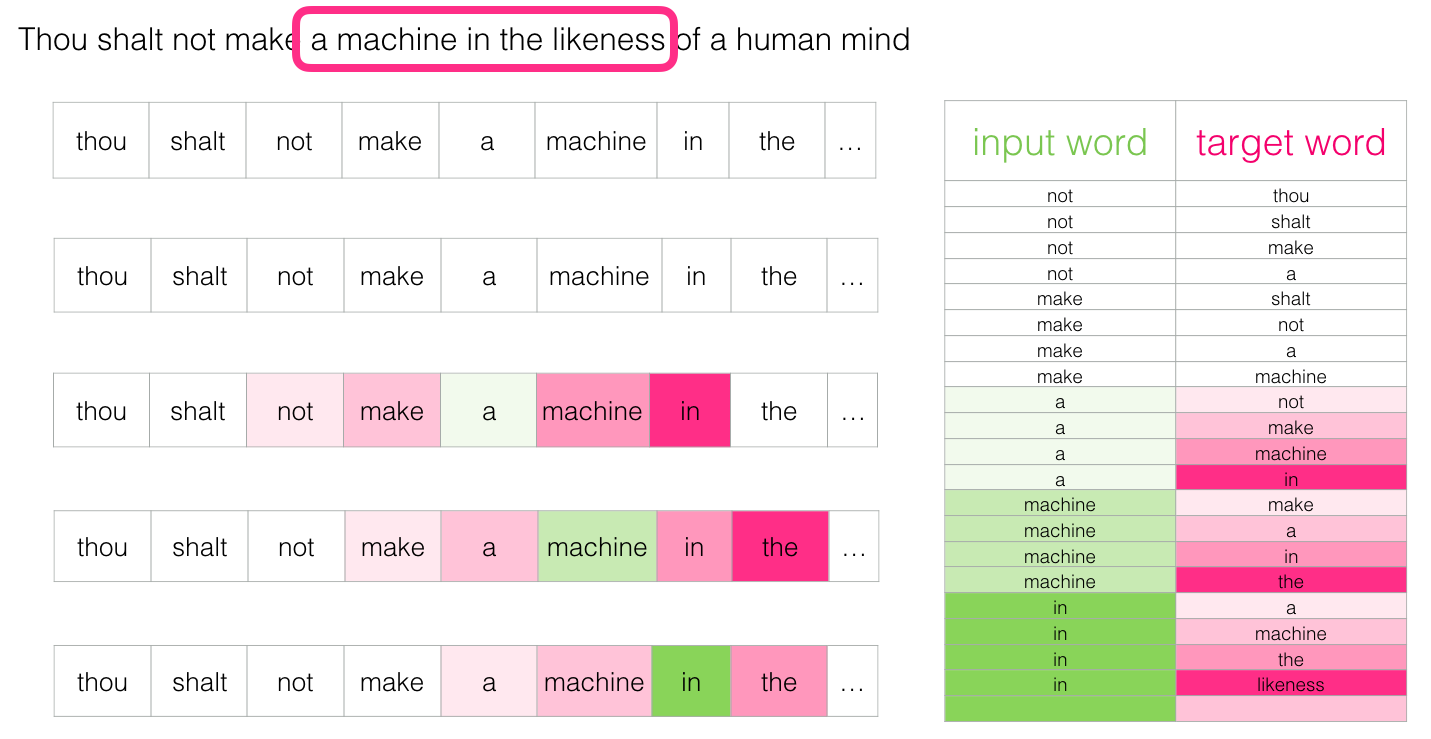
Skip-gramは、CBOWで扱うコンテキストとターゲットを逆転させて、ターゲットから、周囲の複数ある単語(コンテキスト)を推測します。
実際、単語の分散表現の精度の点において、多くの場合、Skip-gramモデルの方が良い結果が得られています。特に、コーパスが大規模になるにつれて、低頻度の単語や類推問題の性能の点において、Skip-gramモデルの方が優れている傾向にあります。
- Mikolov, T., Yih, W., & Zweig, G. (2013). Linguistic Regularities in Continuous Space Word Representations. In L. Vanderwende, H. Daumé III, & K. Kirchhoff (Eds.), Proceedings of the 2013 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (pp. 746–751). Association for Computational Linguistics. https://aclanthology.org/N13-1090